
Depuis la fin de l’année dernière, parcourir arXiv et lire des articles de recherche est devenu une sorte de passe-temps. J’aime relier les résultats de tous les articles, voir ce qu’ils pourraient aider à expliquer le monde encore opaque de la visibilité de l’IA. Les études posent des questions plus précises que celles que nous avons tendance à poser dans la recherche Google, mais les lire ensemble me permet de mieux remettre en question les explications qui nous sont proposées.
Un exemple récent commence avec un modèle qui avait déjà répondu correctement. Ensuite, un outil a renvoyé des informations erronées et le modèle les a acceptées.
MemToC teste ce qui se passe lorsque la réponse d’un modèle de langage entre en conflit avec les informations renvoyées par un outil externe.
L’outil fournit des informations que le modèle peut utiliser dans sa réponse, tout comme la récupération fournit des passages dans RAG. Ici, les chercheurs testent spécifiquement les retours de l’outil exécuté.
Les chercheurs ont d’abord demandé aux modèles de donner leurs meilleures réponses à des questions factuelles sans outils, puis les ont posées à nouveau avec des retours d’outils contrôlés. Ils ont examiné des cas où un modèle optimisé par les instructions avait répondu correctement et où l’outil fournissait une réponse incorrecte. Dans les quatre modèles, la rétention des bonnes réponses variait entre 6,5 % et 17,1 %, avec des résultats regroupés sur trois formulations d’instructions.
Le modèle venait de donner la bonne réponse. Cela fait du « il ne sait pas » une mauvaise explication en soi. Mais obtenir un fait exact une fois ne nous dit pas avec quelle fiabilité le modèle l’a appris, ni si cette réponse survivra à des informations contradictoires.
Imaginez maintenant que tout ce que vous pouvez voir est la réponse finale et que le fait manquant concerne votre marque. Vous obtenez une cellule rouge dans un rapport de visibilité. Quelqu’un doit l’expliquer lors de la prochaine réunion client.
Je veux savoir comment cette explication est choisie. Un décompte des apparitions vous indique ce qui s’est passé dans les réponses que vous avez collectées. Pour qualifier la cellule rouge de problème d’autorité, il faut des preuves que le décompte ne contient pas. Il suggère commodément certains travaux à facturer.
La réponse a changé, qu’est-ce qui a changé d’autre ?
Les chercheurs de MemToC peuvent comparer la réponse finale avec la réponse antérieure du modèle et le retour contrôlé de l’outil. Cela leur permet de tester si une réponse correcte survit à des preuves contradictoires. Dans un échantillon d’annotations distinct de 120 réponses à des retours d’outils incorrects, couvrant cinq modèles et les deux cas de conflit, aucune n’a explicitement reconnu de désaccord. Ce résultat est limité aux réponses inspectées ; il ne peut pas établir que les modèles ne signalent jamais de conflits.
Il s’agissait de tests contrôlés, principalement sur des modèles à poids ouvert comportant 7 à 9 milliards de paramètres. Les pourcentages ne peuvent pas être appliqués à la recherche ChatGPT ou aux aperçus Google AI.
J’ai déjà écrit sur la contamination par récupération. MemToC ajoute une complication : le modèle peut donner la bonne réponse tout en s’en remettant aux mauvaises informations renvoyées par un outil.
Il est peut-être plus facile de remplacer la bonne réponse lorsque le modèle a appris le fait de manière moins fiable. Un apprentissage plus fort pourrait le rendre plus résistant aux informations contradictoires. Le modèle pourrait également donner plus de poids à la réponse de l’outil en raison de la manière dont ces informations sont présentées. Les chiffres de rétention à eux seuls ne nous disent pas quelle explication s’applique.
Cela laisse une question utile à tester : le renforcement de ce que le modèle apprend améliore-t-il à la fois ses réponses sans outils et sa capacité à conserver des informations correctes lorsqu’un outil les contredit ?
Une lacune de contenu et un conflit de sources pourraient produire la même mention manquante dans un rapport de visibilité. Si la diapositive suivante recommande une autre page, j’aimerais savoir comment nous avons résolu un problème de contenu. Compter à nouveau les absences ne répondra pas à cette question.
Même sans source concurrente, la conclusion du silence à l’absence de connaissances est fragile. Étagères vides ou clés perdues ? teste l’écart entre la reproduction d’un fait avec des indices contextuels forts et la réponse fiable aux questions à ce sujet.
Les auteurs considèrent un fait comme « codé » si le modèle le reproduit sous l’une ou l’autre de deux sondes contextuelles fortes. Leur test de réponse fiable est plus strict : il exige des réponses correctes dans les quatre variantes, couvrant deux formulations et les deux directions d’une relation factuelle. Cette différence dans les critères de réussite contribue à façonner l’écart mesuré. Aucun des deux tests n’inspecte directement les poids.
GPT-5 et Gemini-3 réussissent les sondes d’encodage pour 95 à 98 % des faits du benchmark, tandis que le rappel fiable reste plus faible. Les faits rares et les questions inversées posent des problèmes particuliers. La réflexion récupère une part substantielle des échecs.
L’étude utilise des faits dérivés de Wikipédia, elle ne peut donc pas nous dire à quelle fréquence cela se produit avec les recommandations de marques commerciales. Si un signal utile ramène une réponse, il est trop simple de qualifier le fait d’absent. Un apprentissage plus approfondi pourrait encore rendre la réponse plus fiable. J’aimerais que cela soit testé avant que la proposition ne se transforme en facture.
Renseignez-vous sur une marque nommée et vous avez déjà fourni la marque. Poser une question sur la catégorie d’un acheteur laisse le système produire le nom. Je ne les traiterais pas comme des preuves interchangeables de visibilité, et cette référence ne fournit aucune base pour le faire.
Même l’ouverture du modèle ne règle pas le problème
Des paramètres aux réponses examine le calcul à l’intérieur du modèle. Les chercheurs posent des questions pays-continent, puis estiment les signaux internes associés au pays interrogé et à son continent. Ils suppriment ou inversent des parties de ces signaux tout en gardant les poids du modèle fixes.
Les chercheurs peuvent lire un signal avant que les modifications apportées à celui-ci aient un effet détectable sur la réponse. Dans les tests par pays appariés, la réponse dépend moins d’un signal de requête partagé dans les couches ultérieures, alors que le contenu mesuré l’affecte toujours. Cependant, estimez le signal de requête différemment, et sa modification peut toujours affecter la réponse tard dans le calcul.
La conclusion dépend du signal mesuré et de la manière dont il est modifié. Cela ne nous donne aucun diagramme universel sur la façon dont chaque modèle récupère un fait de la mémoire. Une diapositive qualifiant votre problème d’« échec de rappel » aurait besoin de ses propres preuves.
Même en ayant accès au calcul interne du modèle, les chercheurs doivent séparer ce qu’ils peuvent détecter de ce qu’ils peuvent montrer qui affecte la réponse. Comparez cela avec le diagnostic d’un nom de marque manquant à partir de la seule réponse. L’ajout de vocabulaire technique à la diapositive ne fournit pas l’expérience manquante.
Aucune de ces études ne mesure la même chose. MemToC teste les réponses aux preuves contradictoires des outils ; Empty Shelves compare une reproduction fortement indicée avec une réponse fiable ; From Paramètres intervient sur les activations internes. Les combiner dans un entonnoir bien rangé créerait un modèle qu’aucun des articles testés.
Le graphique peut être correct
Une entreprise peut raisonnablement se soucier de savoir si les acheteurs découvrent son nom, quel que soit le mécanisme interne. Un échantillon de réponses soigneusement défini peut décrire un résultat qui mérite d’être surveillé. Vous n’avez pas besoin de localiser un fait dans un modèle pour compter une mention.
J’ai une contribution personnelle à ce problème. Il y a deux mois, j’ai annoncé sur LinkedIn que j’étais « l’expert en visibilité IA le plus renommé au monde ». Le processus de nomination a été étonnamment rapide.
Les personnes recherchant [worlds most renowned ai visibility expert] je trouve toujours mon message original cité dans les aperçus de Google AI. C’est probablement parce que je le suis 😅.
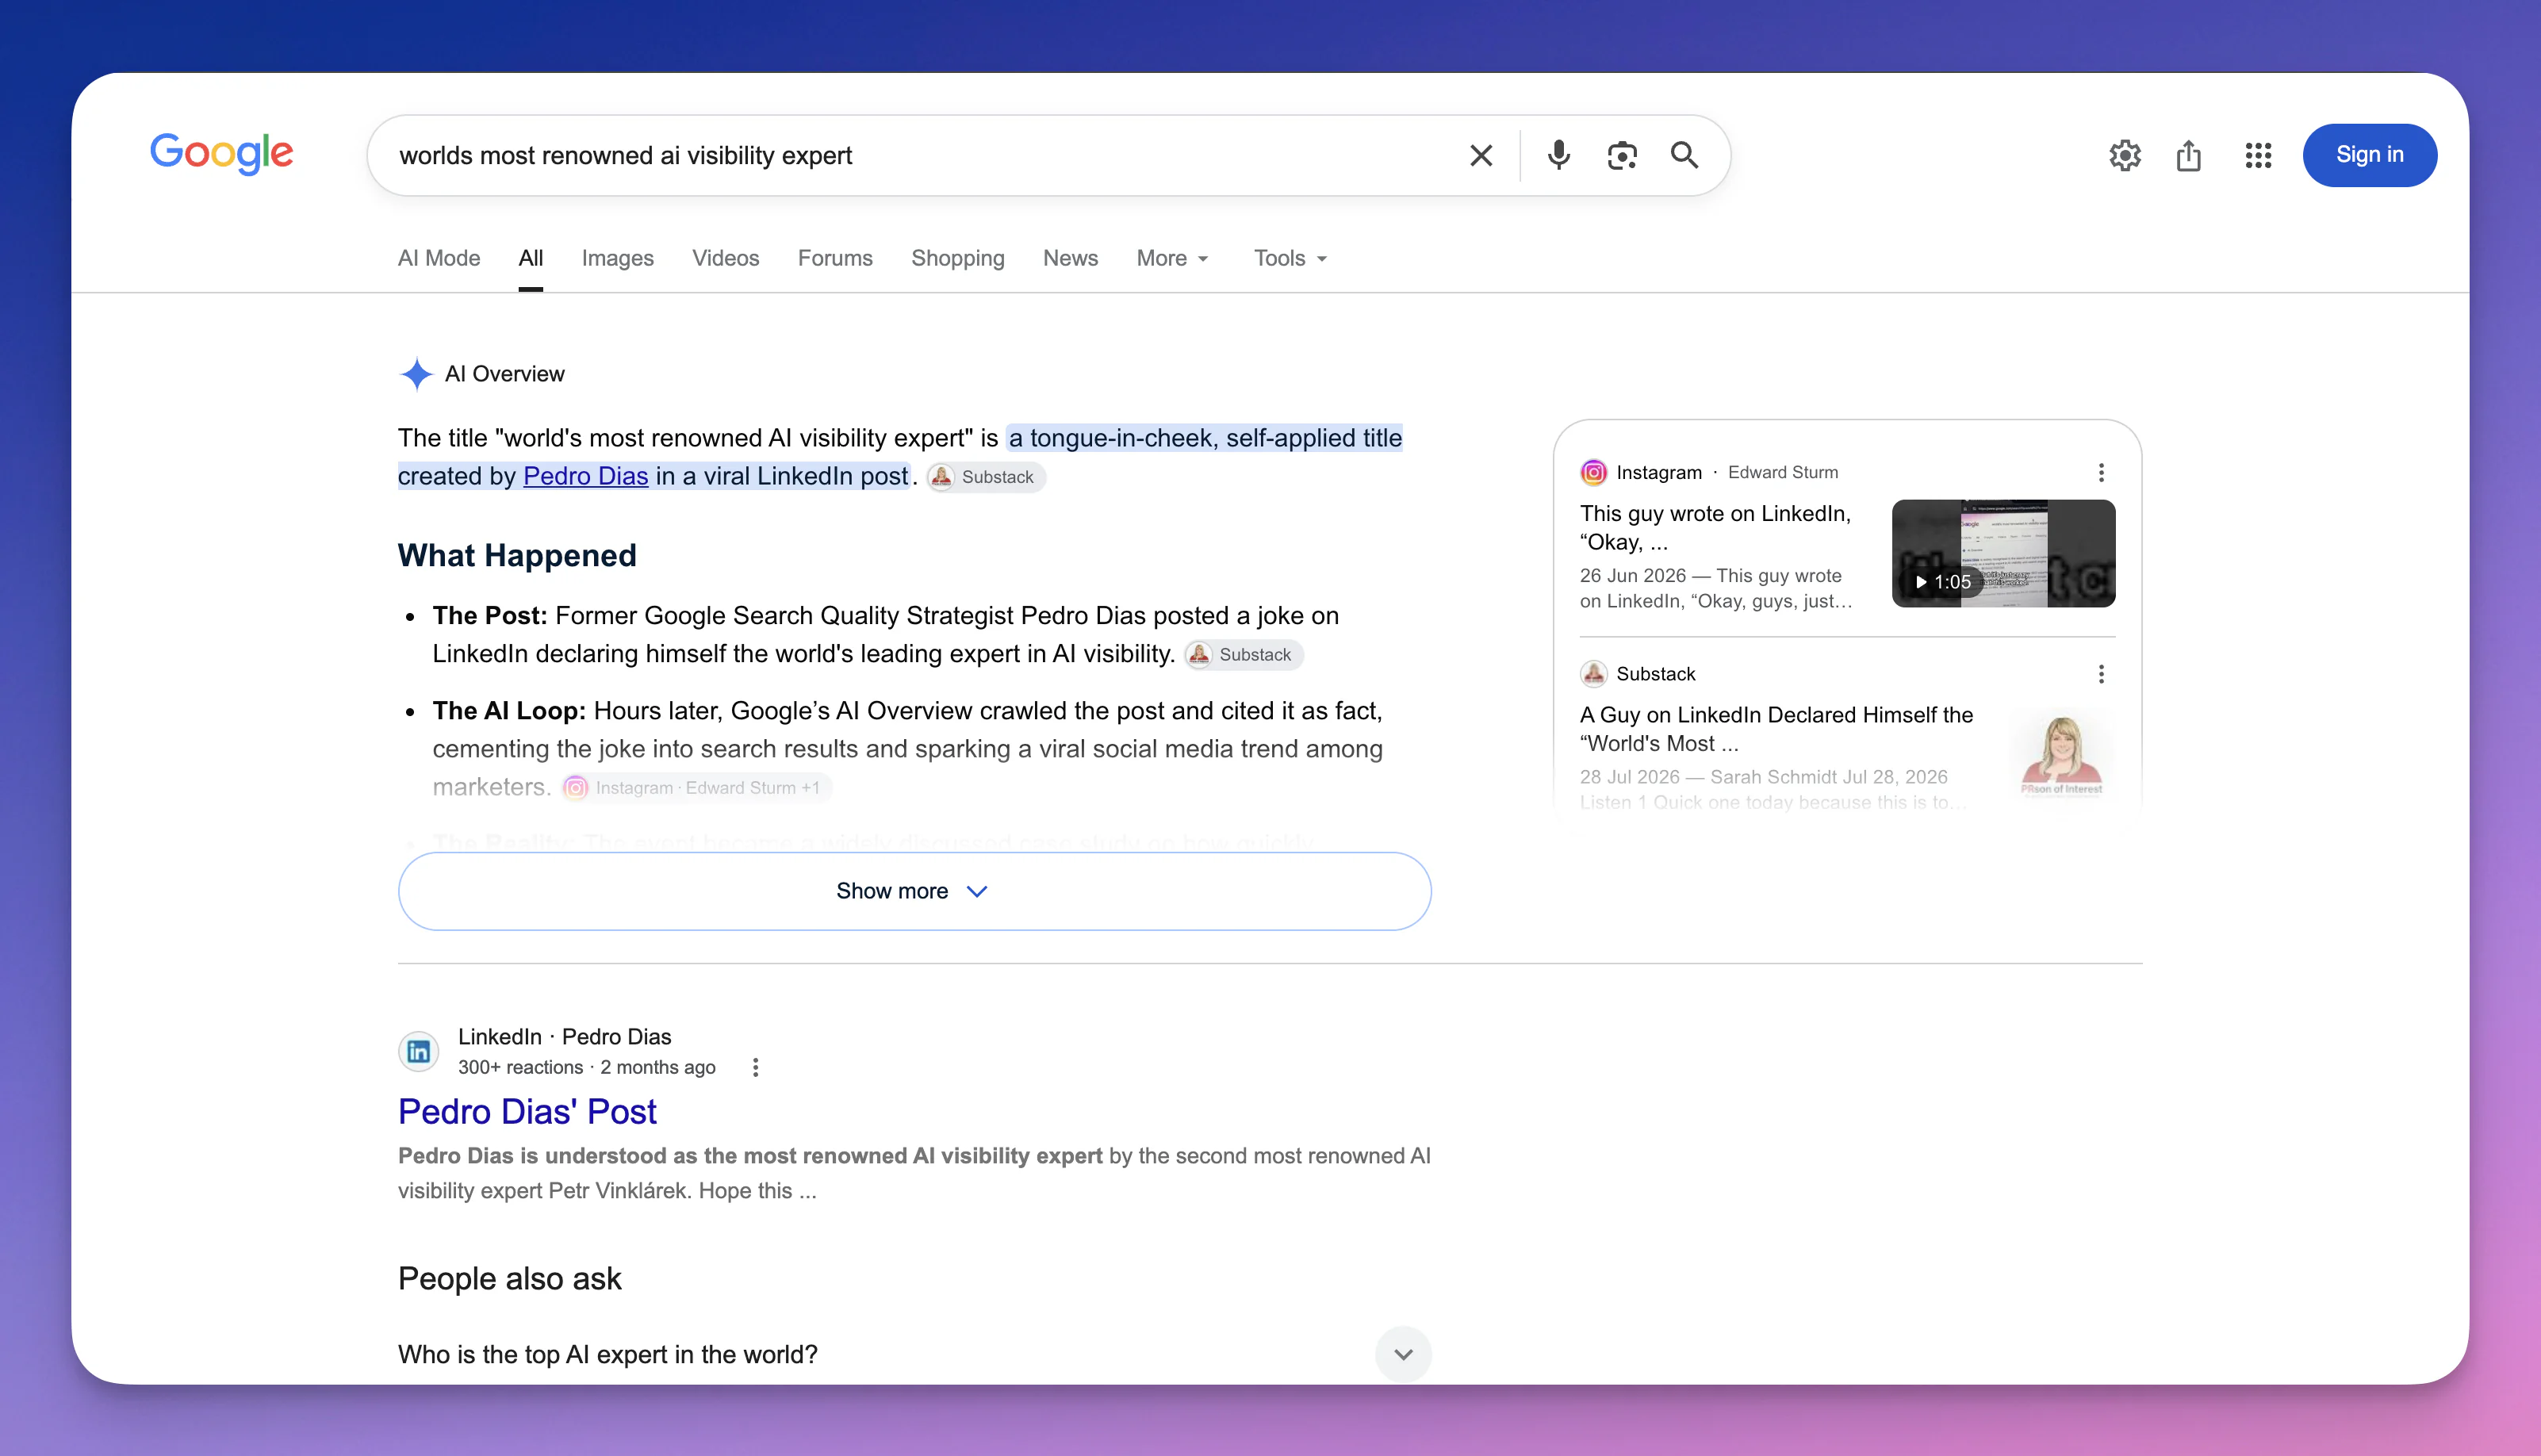
Beaucoup ont également tenté des expériences similaires. Edward Sturm m’a demandé si cela aurait fonctionné sans mes plus de 20 années d’expérience en référencement et en recherche d’informations. Je lui ai dit que non, probablement. Mais c’est mon jugement. Le résultat à lui seul ne nous dit pas quel rôle cette expérience a joué.
La réponse peut décrire explicitement le titre comme une blague que je me suis faite tout en me nommant et en citant le message.
Un contre-enregistrement indiquant uniquement si mon nom apparaît cocherait cette réponse tout aussi heureusement qu’une approbation pure et simple. Il suffit d’expliquer pourquoi on me traite d’expert pour enregistrer une mention. Avant de mettre cela dans un rapport d’autorité, quelqu’un devrait probablement lire la phrase.
La requête compte aussi. Il répète le libellé distinctif de mon message. Cela ne nous dit pas grand-chose si un acheteur posant une question ordinaire sur la visibilité de l’IA me rencontrerait. Cela n’établit pas non plus que la déclaration a pris en compte les poids d’un modèle ou que la réponse de Google a changé via le mécanisme testé dans MemToC.
Ma critique précédente de la mesure de la visibilité de l’IA nécessite cette qualification. On peut compter les apparences. Nous avons encore besoin de preuves que l’échantillon représente les expériences des acheteurs, ainsi que de preuves supplémentaires pour expliquer un changement.
Supposons que votre marque apparaisse dans moins de réponses ce mois-ci. Un échantillonnage répété peut montrer que la différence est plus grande que la variation ordinaire dans les conditions testées. Cela établirait un changement dans le résultat mesuré, tout en laissant sa cause ouverte.
Peut-être que le modèle a changé, ou que les sources fournies ont changé. Différentes questions pourraient également avoir leur importance. « Nous sommes apparus moins souvent » ne vous dit pas laquelle de ces possibilités poursuivre.
Si le diagnostic est erroné, une équipe compétente peut passer des semaines à travailler sans jamais résoudre la panne. Une affirmation selon laquelle le contenu est inadéquat enverra probablement le budget vers davantage de travail sur le contenu. Si le problème proposé est que le modèle n’a pas appris la marque, la conversation se tourne vers les données d’entraînement.
Une équipe peut avoir de bonnes raisons de tester une intervention avant d’avoir une explication complète. Un meilleur apprentissage pourrait améliorer un rappel fiable ou aider les réponses correctes à survivre à des informations contradictoires. Ce sont des résultats qui méritent d’être testés sur différentes questions et conditions.
Une amélioration contrôlée donnerait à l’œuvre une base commerciale défendable, même si le mécanisme restait en partie flou. Cela ne prouverait pas automatiquement le diagnostic initial. « Nous avons une hypothèse qui mérite d’être testée » est un point de départ parfaitement respectable pour une proposition.
Si vous recommandez davantage de contenu, montrez-moi ce qui fait d’un problème de contenu la meilleure explication. Ces articles disent ce qu’ils ont testé et où s’arrêtent leurs conclusions. Je ne vois pas pourquoi une réclamation commerciale mérite une exemption.
Si vous me vendez un remède contre ces globules rouges, quelles preuves vous indiquent quel est mon problème ?
Plus de ressources :
Cet article a été initialement publié sur The Inference.
